調査と脅威モニタリングのためのOSINT検索テクニック
 Nicholas Van Landschoot
調査と脅威モニタリング向けにより良いOSINT検索を構築。いつ広く検索し、ブール検索を使い、文脈を収集し、AIでフィルタリングするかを学びます。
検索戦略が、何が見つかり、何が見逃されるかを決めます。関心人物の調査、企業のリサーチ、経営幹部やブランドに対する脅威のモニタリングのいずれでも、その原則は同じです。
リスクは、最初の結果を確認する前から始まります。クエリに誤った制限を加えると、関連コンテンツは調査に届きません。収集しなかったデータから、後段のフィルタで復元することはできません。
効果的なOSINT検索戦略は、対象のリサーチ、広範な発見、プラットフォームごとの検索ルール、結果のレビューを組み合わせます。直接のキーワード一致だけでなく、投稿に意味を与えるアカウント、会話、関連トピックにも及びます。
本ガイドは大規模な検索とモニタリングに焦点を当てます。目的は、大量データの中から関連する公開情報を収集しつつ、収集コストとレビュー工数を抑えることです。
OSINT検索戦略はGoogle dorkingを超える
Google dorkingは、特定サイトや完全一致フレーズへの限定など、高度な検索演算子で結果を絞り込む手法です。有用ですが、問題の一部に過ぎません。
Jason HillのGoogle Dorking for OSINT: The Practical Investigator's Guideは、その部分の作業に役立つ参照資料です。
より広い検索戦略は、カバレッジについても問いに答えます。どの名称と関連トピックを含めるべきか。どのソースを検索できるか。返信や添付メディアはどう扱うか。対象が変化したとき、ギャップをどう検知するか。
精密なクエリは、必要な情報を返し続ける場合にのみ価値があります。
1. キーワードを選ぶ前に目標を定める
まず、何を見つける必要があるか、見逃しが意味することを定義します。
デューデリジェンスでは、企業の所有関係、争い、公開履歴を確立する必要があるかもしれません。要人警護では、明らかな脅迫語を使わないコンテンツも含め、人物に関する関連議論を見つける必要があります。目的によって、ソース、用語、レビュールールは異なります。
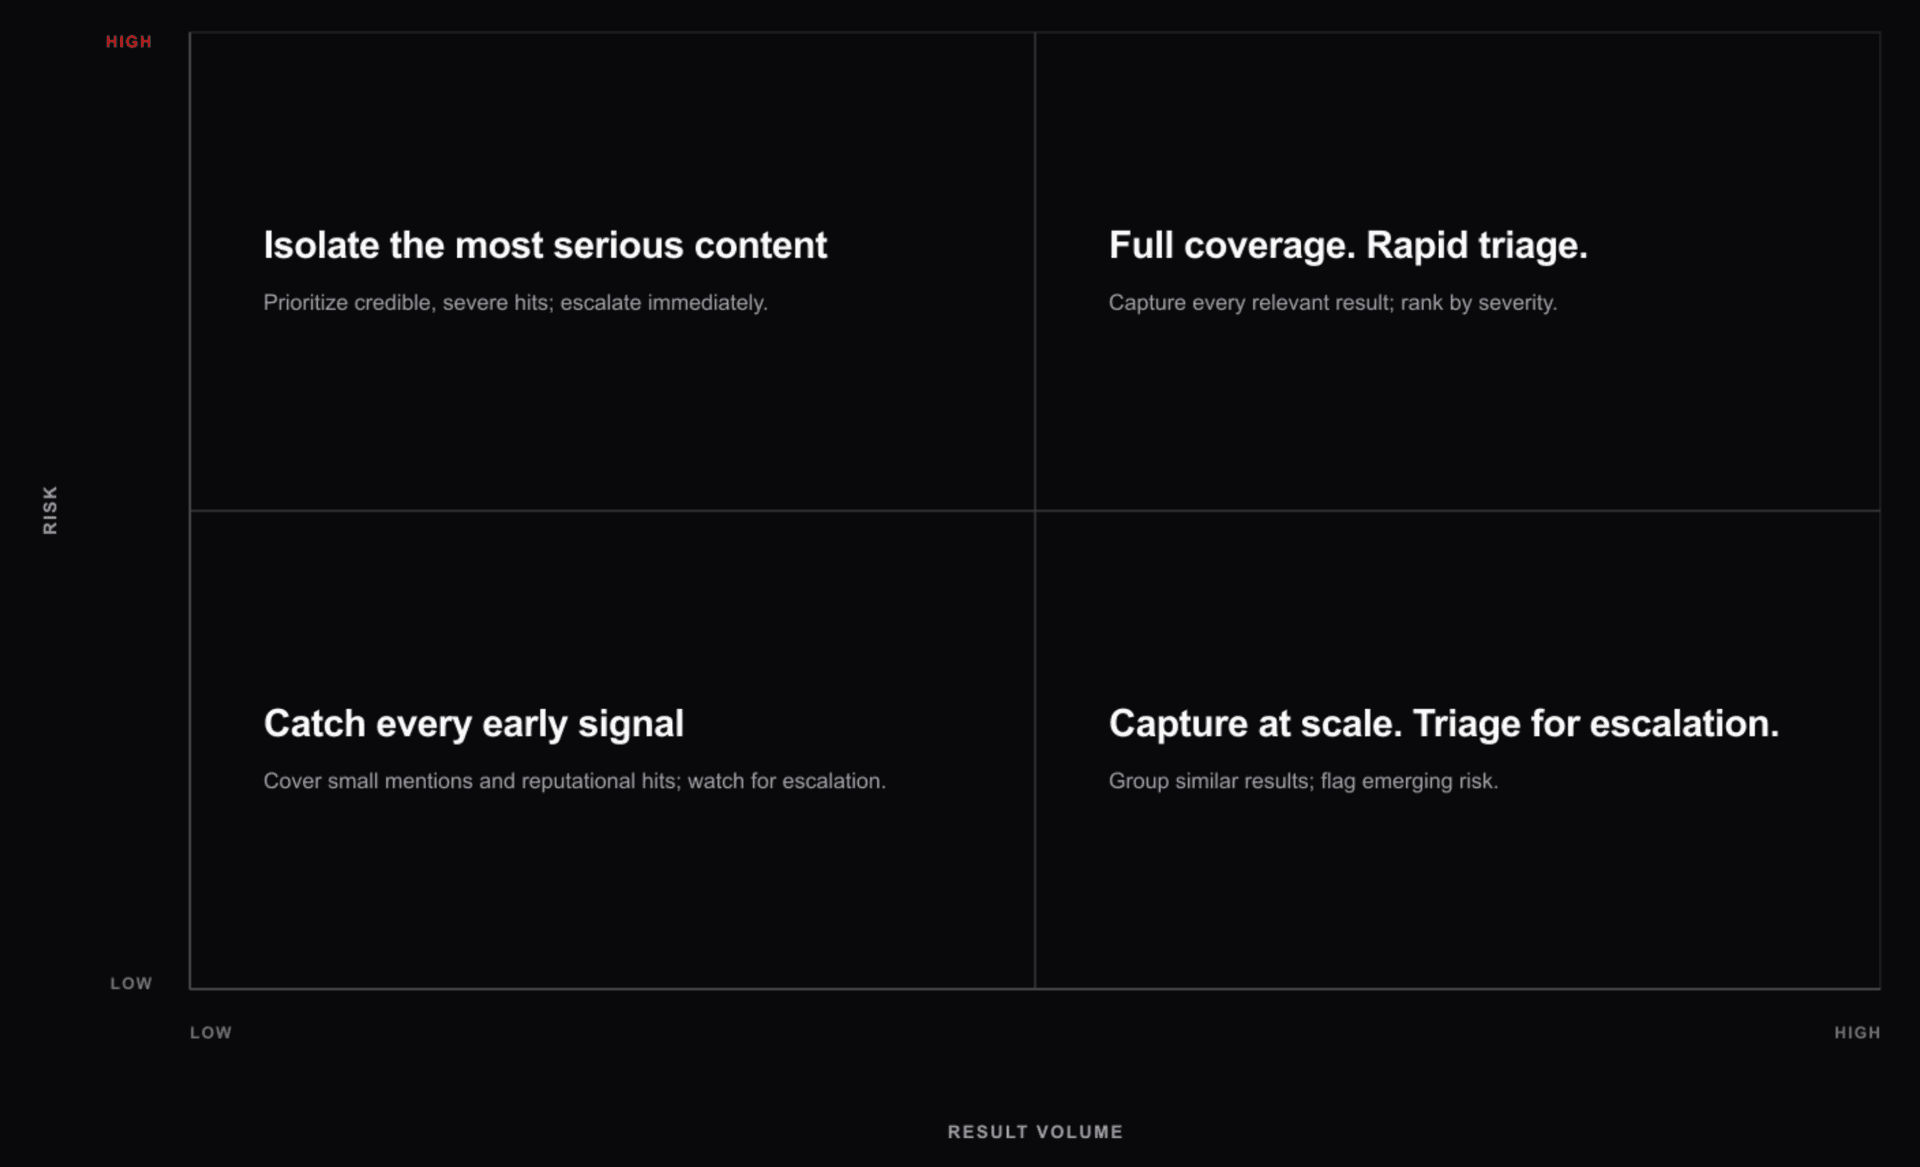
次にボリュームを測定します。「高ボリューム」とは、結果上限、コスト、遅延など、実際の収集限界を指すべきです。単にアナリスト一人が読みたい量を超える投稿数、という意味ではありません。
特徴的な経営幹部の名前は広い収集を支えられます。グローバルブランドや一般的な語由来の社名は、無関係なコンテンツをはるかに多く生みます。通常は静かな名前でも、大きなイベント中は急増することがあります。
クエリをより制限的にする前に、短い収集サンプルで前提を検証します。
低ボリュームの用語では広く検索します。修飾なしでコア用語を検索する方が、通常はカバレッジが良く、関連コンテンツの見逃しリスクを下げます。真に高ボリュームの用語では、特定の修飾を一つまたは少数加えることで、収集量を減らしつつ検索を有用に保てる場合があります。
| 検索状況 | 開始アプローチ | 確認すべき主なリスク |
|---|---|---|
| ボリュームが管理可能な特徴的な名前 | 名前と重要なバリアントを広く検索 | 間接参照や別名の見逃し |
| 複数人が共有する一般的な名前 | 異なる身元手がかりで複数検索 | 関連投稿が省略する詳細を必須にすること |
| 無関係な意味を持つブランド名 | 狭い除外や文脈別クエリを試す | 両方の意味を論じる投稿の除去 |
| テロリズムなどの広いトピック | 関連する場所、イベント、ソース、サブトピックを定義 | アクセスと予算を超える収集 |
収集が管理可能な範囲では検索を広く保ち、測定されたボリュームや曖昧さがカバレッジ低下を正当化するときだけ絞り込みます。
2. 名前以外の対象をリサーチする
クエリを書く前に、人々が対象をどう呼ぶかを把握します。
企業なら、ブランド、製品、経営幹部、施設、プロジェクト、関連する地域課題を集めます。人物なら、公開別名、肩書、アカウントハンドル、調査に関連する既知の関係を検討します。対象の活動上必要なら、他言語や音訳も含めます。
架空の Alder Ridge Holdings が、地域では Eastbank プロジェクトとして知られる倉庫を建設していると想像してください。住民は「Eastbank」「新しい倉庫」、計画紛争について、会社名を出さずに議論するかもしれません。
「Alder Ridge Holdings」だけをモニタリングすると、結果のフィルタがどれだけ優れていても、その議論は見逃されます。
各検索語が何を指し、なぜ調査に含めるのかを短く記録します。別のアナリストが引き継いだとき、設定のレビューと更新が容易になります。
3. クエリ拡張を前提にせずテストする
一部の検索システムは関連形を返したり、語句を超えてクエリを解釈します。他は提供した用語に強く依存します。
引用なし検索がすべての誤字、ニックネーム、略称、翻訳を見つけると仮定しないでください。プラットフォームのWebサイト、そのAPI、データを使う第三者ツールでは挙動が異なります。
実際に収集するインターフェースでテストします。既知の公開例で、重要なバリアントがクエリで見つかるか確認します。
実務的なアプローチは、重要な名称と別名の明示的検索と、より広い発見クエリの組み合わせです。考えうるすべての誤字を列挙する必要はありません。対象リサーチや観察結果に理由があるときにバリアントを追加します。
重複は想定内です。可能なら安定した投稿識別子で重複レコードを除去することを優先します。広いクエリから用語を除外すると、狭いクエリが失敗したり、収集上限に達したり、別期間をカバーしたりした場合にギャップが生じます。
4. プラットフォームとアクセス方法ごとにクエリを構築する
同じクエリがどこでも同じように動くわけではありません。
Xの高度な検索インターフェースは、語、完全一致フレーズ、除外、アカウント、日付のオプションを提供します。APIのクエリドキュメントは、アクセスレベルに依存する制限とクエリ構築を別途説明しています。ブラウザで動くクエリも、収集ツールで再テストすべきです。
各ソースについて、何を検索・取得できるか確認します。結果に返信が含まれるか、どこまで遡れるか、追加ページの要求が必要か、ランキングや結果上限が受け取りを制限するかを調べます。
キーワード検索が弱く特定公開アカウントへのアクセスが有用なソースでは、アカウントモニタリングがより良い出発点になることがあります。どちらも乏しい場合は、許可された範囲で検索エンジンによる発見や別データソースが助けになりますが、カバレッジ限界は記録します。
クエリ設計とソースアクセスは同じ問題の別パートです。よく書かれたクエリでも、関連コンテンツを公開しないソースは克服できません。
5. ブール検索で曖昧さを解消する
ブール検索は、代替、必須語、除外を組み合わせます。広い用語に複数の意味がある、または収集可能量を超えるコンテンツを生むときに最も有用です。
論理は単純ですが、構文はプラットフォームごとに異なります。
| 検索ロジック | 目的 | 注意点 |
|---|---|---|
| OR | 名称、別名、その他の代替を含める | 広い代替が結果を支配しうる |
| AND | 別の関連概念を必須にする | 関連投稿がその概念を省略しうる |
| 完全一致フレーズ | 特定の語順に一致 | 言い回しの違いが見逃されうる |
| 除外 | 既知の無関係結果源を除去 | 関連投稿にも除外語が含まれうる |
対象がスポーツチームと同名だとします。チームの正式名称を除外する方が、すべての結果に対象の雇用主を必須にするより制限が緩い場合があります。
ただし除外が何を除去するか検査します。脅迫は対象をチームと比較したり、両方に言及する会話の中に現れたりする可能性があります。
複数の意味が競合するとき、長い必須語リストの単一クエリより、文脈別の複数クエリの方が制御しやすいことが多いです。
6. 脅迫キーワードだけを収集の入口にしない
経営幹部の名前と「kill」などの語の両方を要求するクエリは、ごく狭い発言集合しか見つけません。
別名を使うコンテンツ、親投稿の文脈に依存するコンテンツ、予測しなかった表現で意図を示すコンテンツを見逃します。明示的な脅迫を含まなくてもレビューに値する関連行動も見逃します。
ボリュームが許す範囲では、まず対象に関する議論を収集し、その後意味を評価します。直接的な脅迫クエリはその収集を補完できますが、全体の範囲を定義すべきではありません。
特定の言語にも役割があります。関連コミュニティ、地域方言、繰り返しの議論で観察された用語は、正式名称では現れない素材を示すことがあります。これらの用語はリサーチと実際の結果から構築します。
人々が使う言語で検索し、アナリストが行動を説明する語だけに頼らないでください。
7. 返信、メディア、周辺文脈を収集する
関連コンテンツの一部には、元のキーワードが一つも含まれません。
「彼はここに来ることを後悔するだろう」という返信は、単体ではほとんど意味がありません。経営幹部と来訪予定を名指しする投稿の下では、明確な対象があり、文脈付きレビューに値します。それでも自動的な脅迫ラベルではなく評価が必要です。
利用可能なら、親投稿、関連返信、引用、添付メディア、ソース参照を保持します。案件に関連するときは、つながったアカウント活動もレビューします。
これはキーワード追加とは異なる拡張です。コンテンツ間の明示的な関係を辿ります。
欠落した文脈も記録します。削除された親投稿や利用不能な動画は、評価上の目に見えるギャップを残すべきです。利用不能な情報を、懸念が存在しない証拠として扱うべきではありません。
8. 収集後にAIフィルタを使い、却下内容をテストする
言語モデルは、キーワードだけでは表現しにくい基準で収集コンテンツを分類するのに役立ちます。それにより、一部のチームではより広い収集が実務的になります。コストと精度は、モデル、コンテンツ、文脈、レビュー基準に依存します。
関連性と脅威評価を分けます。まず項目が正しい対象に関するかを問い、次に何を述べ、レビューが必要かを評価します。不確実な項目は人が確認できるよう残します。
判断に必要な文脈を渡します。対象が親投稿や画像にのみ現れる場合、返信テキストだけを受け取るモデルは本質的情報を欠きます。
アナリストがレビューした例に対してフィルタを評価します。間接参照、曖昧な名前、他言語、引用された脅迫、文脈では無害だが懸念に見えるコンテンツを含めます。
最も重要なのは、却下結果のサンプリングです。モデルが受理した項目だけをレビューしても、落とした関連素材についてはほとんど分かりません。
元コンテンツを保持し、使用したフィルタリングルールまたはモデルのバージョンを記録します。ギャップ発見時に過去の判断を見直す手段が必要です。
9. ネイティブ検索が不十分なときの代替手段
ネイティブプラットフォーム検索は情報への経路の一つです。ソースとアクセス次第では、公開アカウントフィード、検索エンジンインデックス、公開アーカイブ、ライセンスデータフィードなどもあります。
経路ごとに強みが異なります。検索エンジンはアカウントやページの発見に役立ちます。アーカイブは履歴調査を支えます。キーワード検索が弱いとき、アカウントフィードは継続性を提供します。
カバレッジと遅延を確認せず、完全な代替とみなすべきではありません。インデックスされたページが、そのアカウントのすべての投稿や返信が利用可能であることを意味しません。
許可されたアクセスとコストが許せば、定義した公開コンテンツ本体を自社の検索可能インデックスに収集することも有用です。まず範囲を定義します。広い取り込みはリサーチ需要に奉仕すべきで、それ自体が目的になってはいけません。
AI検索はソース発見に役立ちますが、根拠リンクは保持して検証します。生成された回答は収集記録ではありません。
10. 直接リンクを超えた関連議論を見つける
返信とメンションを辿ると、明示的つながりのあるコンテンツが見つかります。関連議論の一部にはそのようなリンクがありません。
二つのアカウントが同じ地域紛争を異なる用語で論じることがあります。新しいコミュニティがプロジェクトに別名を採用することがあります。議論が元スレッドへのリンクなしに別プラットフォームへ移ることもあります。
トピック分析、意味的類似、関連公開素材の比較は、追加レビューへの手がかりを生みます。アカウントが同一人物に属することや、共有トピックが連携を証明することは確立しません。
Intraceでも取り組んでいる領域です。直接の名称一致や明白なアカウントつながりを超えて発見を広げます。有用な結果は、アナリストが検査・検証できる追加の関連素材です。
各提案つながりの理由を可視に保ちます。別のアナリストが、類似スコアを証拠として受け入れずに評価できるようにします。
11. 対象が変化したら検索を更新する
最初の収集は、初期リサーチでは分からなかったことを教えてくれます。
新しいアカウント名、フレーズ、プロジェクト、場所、争いは検索戦略にフィードバックすべきです。追加をレビューし、現設定では見逃す関連素材を見つけるかテストします。
架空の Alder Ridge 調査では、Eastbank プロジェクトの新しいニックネームがクエリ追加を正当化するかもしれません。一時的な無関係結果の急増は、恒久的除外より短期調整を正当化するかもしれません。
変更ログを残します。何を、なぜ、いつから変えたかを記録します。収集ボリュームの差異を説明し、ソースアクセスが許す範囲で過去の検索を見直せます。
捜査官は新しい手がかりを追うとき、すでにこうしています。継続モニタリングにも同じ習慣が必要です。定期レビューを設定し、対象に関する大きな変化の後に検索を見直します。
12. 結果の見た目のきれいさだけでなくカバレッジを測る
静かなフィードは、重要コンテンツを見逃しながら成功に見えることがあります。
すでに存在すると分かっている関連項目の参照セットを構築します。収集がそれらを見つけるか、文脈を取得するか、フィルタが保持するかをテストします。これはインターネット全体ではなく、そのセットに対するカバレッジを測ります。
次の個別の問いを追跡します。
- クエリは項目に一致したか。
- ソースはアクセス限界内でそれを返したか。
- 収集プロセスはそれを取得したか。
- 関連性フィルタはそれを保持したか。
- 適切な担当者が時間内に受け取ったか。
これらのチェックは失敗箇所の特定に役立ちます。キーワード追加は収集上限を直しません。AIプロンプト変更は欠落した返信を直しません。
レビューに届く無関係素材の量も測ります。良い検索設計は、見逃し、収集コスト、アナリスト時間のバランスを取ります。適切なバランスは調査目的と見逃しの結果次第です。
OSINT検索テクニックに関するよくある質問
Google dorkingとOSINT検索戦略の違いは何ですか。
Google dorkingは検索演算子でインデックス結果を絞り込みます。OSINT検索戦略は、対象リサーチ、ソース選択、クエリテスト、収集、文脈、レビューも含みます。演算子はそのプロセス内の一つのツールです。
OSINT検索は広くすべきか、具体的にすべきか。
対象が特徴的で収集ボリュームが管理可能なら、広く始めます。曖昧さ、コスト、ソース限界が正当化するときに制限を加えます。依存する前に、各制限が何を除去するかテストします。
AIはブール検索に取って代われるか。
目的が異なります。ブールクエリはソースが返す内容を制御します。AIは収集コンテンツの意味評価に役立ちます。AIフィルタは、狭すぎるクエリで除外された素材を復元できません。
対象名を出さない脅迫をどう見つけるか。
関連する人物、プロジェクト、場所、用語をリサーチします。利用可能なら関連返信と会話文脈を収集します。それらの所見から追加検索を開発し、対象の正式名称だけに頼らないでください。
検索戦略を実践に移す
Intraceの調査スイートは、身元リサーチ、リンク分析、ソーシャルアカウントレビューをつなぎます。Digital Risk Intelligenceは、人物と組織に対するオンライン脅威の継続モニタリングを支援します。
チームが検索、収集、関連コンテンツ評価の方法を見直しているなら、Intraceデモを予約してください。対象またはモニタリングユースケースを持参いただければ、チームに必要なカバレッジと文脈に焦点を当てられます。